Extrait des Informations
Fier d’être soutenu par Investissement Québec, Scale AI et Confiance IA. IA multimodale (texte et image) appliquée à la classification de produits dans le commerce de détail. Combinaison de récupération de données, de modèles vision-langage, d’extraction OCR et d’analyse fondée sur les représentations vectorielles.
Étude de cas / 04
Contexte du projet
Classification de produits par IA
Systèmes de recommandation
Intelligence d’affaires pour le commerce de détail
Contribution de Plumfind
IA et systèmes intelligents
Recherche et expérimentation
Infonuagique et infrastructure
Technologies
CLIP, SigLIP, OCR, représentations vectorielles, recherche vectorielle, AWS
Échéancier
Découverte, Expérimentation, Évaluation, Déploiement de la démo
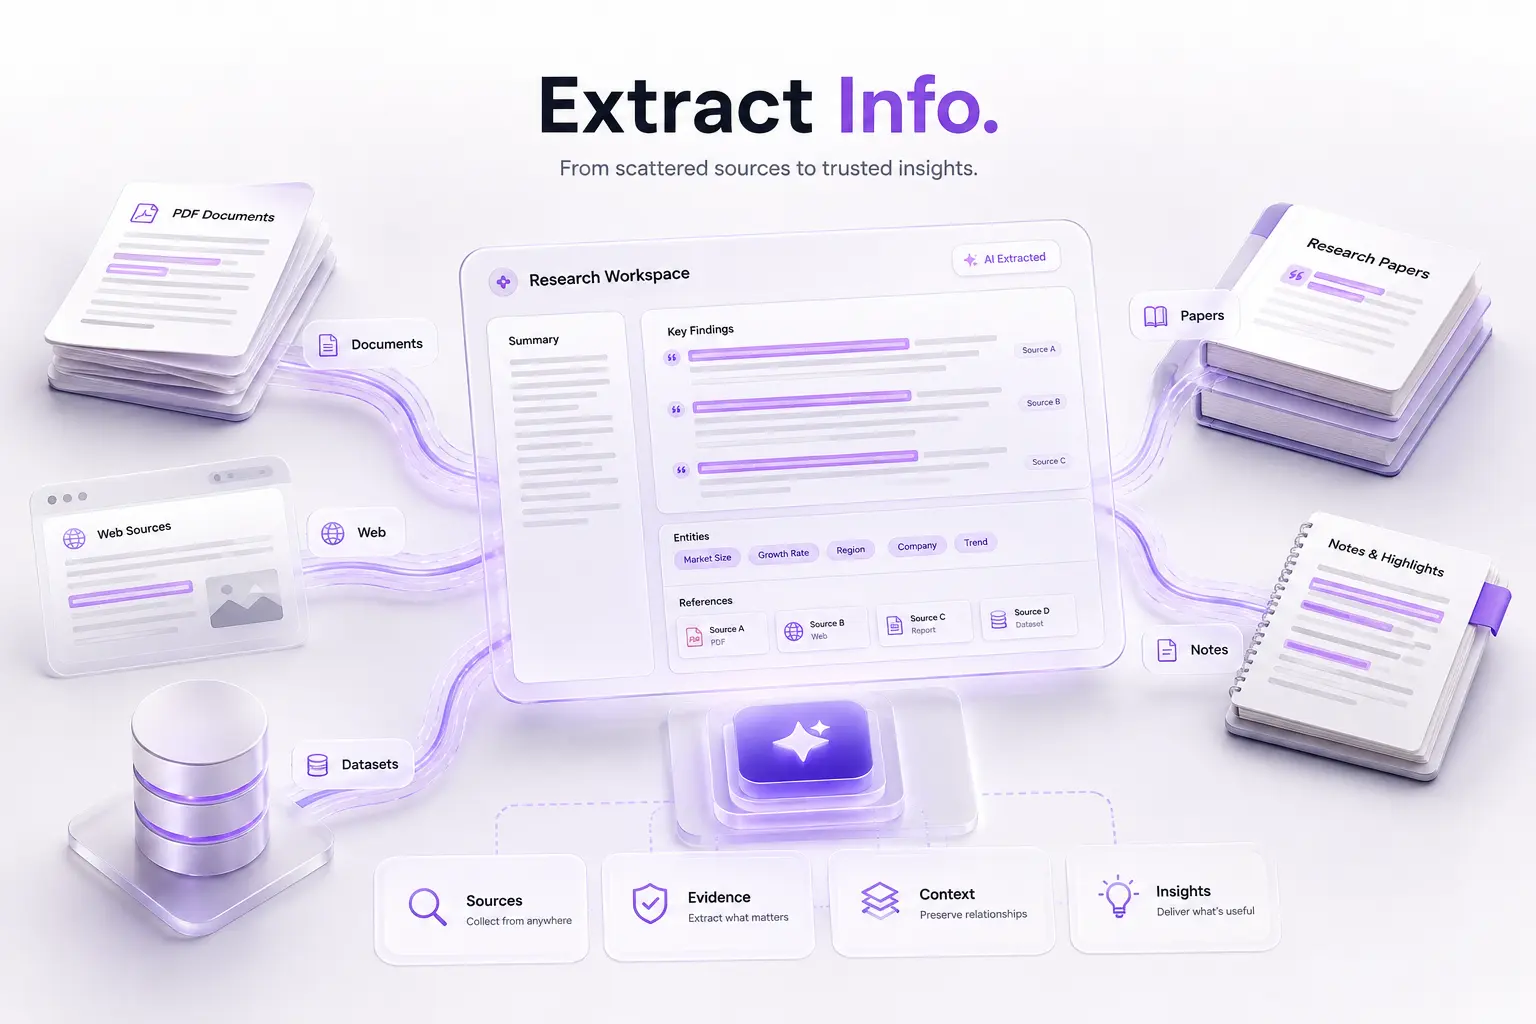
Un projet de recherche appliquée visant à explorer les systèmes d’IA multimodale modernes pour comprendre les produits de détail, retrouver des articles visuellement similaires et extraire des informations structurées à partir d’images réelles de produits.
Aperçu / La raison d’être
Un outil de classification utile commence par une question claire.
Ce qui a été exploré
Approches d’IA multimodale pour la recherche de produits similaires dans le commerce de détail, l’évaluation de modèles, l’extraction OCR et l’analyse des représentations vectorielles.
À qui cela s’adressait
Équipes technologiques du commerce de détail, gestionnaires de commerce électronique, chercheurs et professionnels de l’IA.
Pourquoi c’était important
Comprendre où les modèles vision-langage sont efficaces, où ils montrent leurs limites et comment des systèmes complémentaires peuvent améliorer les flux de travail liés à l’intelligence d’affaires dans le commerce de détail.
LE DÉFI
Les données du commerce de détail sont rarement propres. Les modèles doivent quand même fonctionner.
Les catalogues de commerce électronique contiennent des photos incohérentes, des descriptions de produits variables, des styles changeants et des différences importantes d’un détaillant à l’autre, ce qui en fait un environnement difficile pour les systèmes d’apprentissage automatique.
EXIGENCES
Réduire l’incertitude grâce à l’expérimentation.
Contexte d’affaires
Nous avons commencé par une question simple : dans quelle mesure les modèles multimodaux modernes peuvent-ils comprendre de façon fiable les produits à travers différents ensembles de données, magasins et conditions visuelles?
Approche
Nous avons mis au point une série d’expériences pratiques couvrant la recherche par similarité, l’évaluation comparative de CLIP, l’extraction OCR, le réglage fin et l’analyse au niveau des magasins. Nous avons évalué la performance du pipeline d’IA pour des produits neufs et d’occasion afin de mieux comprendre les capacités des modèles dans des conditions réalistes.
Orientation de l’expérience
Une approche axée d’abord sur la recherche, qui privilégie les observations mesurables, l’évaluation comparative et des résultats explicables plutôt que le déploiement en production.
Plan de production
Une infrastructure infonuagique légère a soutenu l’expérimentation, l’évaluation comparative, l’entraînement des modèles et les démonstrations interactives.
Découverte
La clarté vient de la comparaison.
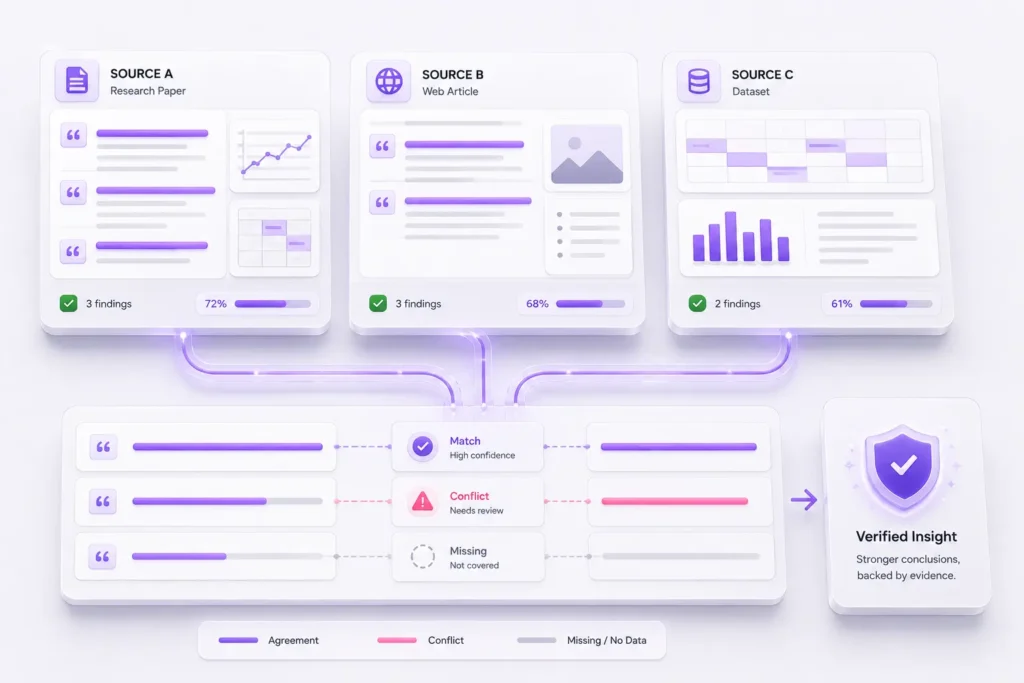
Nous avons comparé plusieurs modèles de vision-langage, systèmes OCR, ensembles de données et environnements de magasins afin de comprendre comment différentes approches se comportent dans des conditions réelles.
Exemple de question de recherche
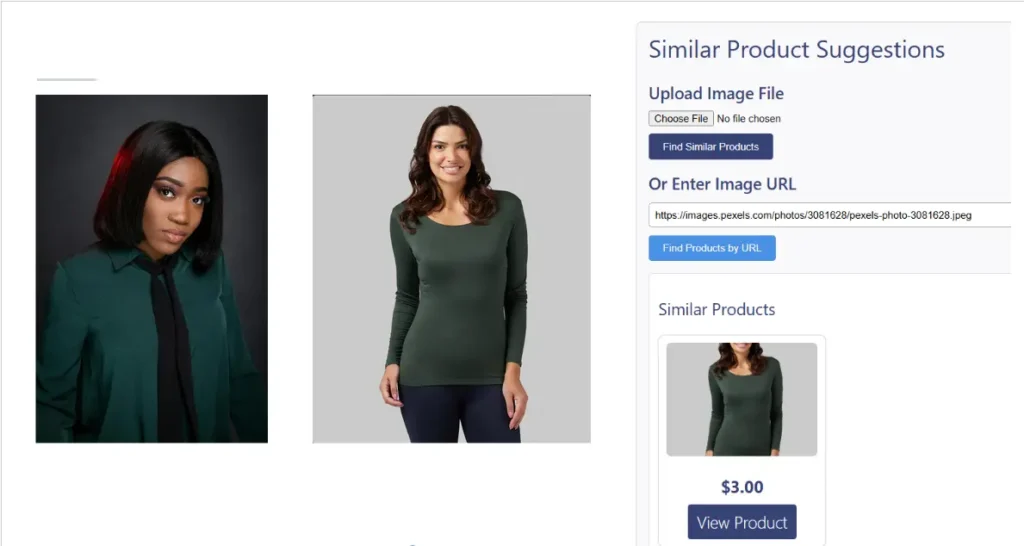
“Les modèles multimodaux modernes peuvent-ils identifier de façon fiable des produits vestimentaires visuellement similaires provenant de différents magasins?”
- Évalué à l’aide de la similarité des plongements vectoriels
- Comparé entre plusieurs variantes de CLIP
- Testé avec des images de commerce de détail provenant de conditions réelles
- Analysé dans des conditions de décalage de domaine (domain shift)
Ce que Plumfind a conçu et évalué.
Une collection d’expériences d’IA appliquée, de cadres d’évaluation comparative, de systèmes de recherche d’information et de flux de travail d’analyse multimodale.
Modèle de contenu
Nous avons regroupé les détails des livres, les épisodes de balados, les thèmes et les métadonnées dans une seule couche source fiable.
Recherche par similarité
Des plongements d’images ont été utilisés pour récupérer des produits visuellement similaires à travers différents ensembles de données.
Évaluation comparative
Plusieurs modèles de type CLIP ont été évalués sur des ensembles de données identiques afin de mesurer leur constance et leur robustesse.
Intelligence OCR
Des informations structurées ont été extraites directement des étiquettes, des balises et des métadonnées des vêtements.
Infrastructure expérimentale
Des environnements d’expérimentation infonuagiques ont soutenu l’entraînement, l’évaluation, le traitement par lots et les flux de travail de démonstration.
Solution / architecture
Conçu comme un parcours de recherche clair et cohérent.
01
Compréhension des images de produits
Des modèles basés sur CLIP ont généré des plongements vectoriels capables de représenter la similarité visuelle entre les produits.
02
Évaluation comparative
Plusieurs modèles de vision-langage ont été évalués à l’aide de bancs d’essai sur des ensembles de données de produits communs afin de mettre en évidence leurs forces et leurs limites.
03
Extraction OCR
Les informations provenant des étiquettes ont été extraites afin de fournir des attributs de produits structurés allant au-delà de l’inférence visuelle.
04
Déploiement expérimental
Une infrastructure infonuagique a permis de réaliser des expériences reproductibles, des pipelines d’évaluation et des démonstrations interactives.
Flux du système
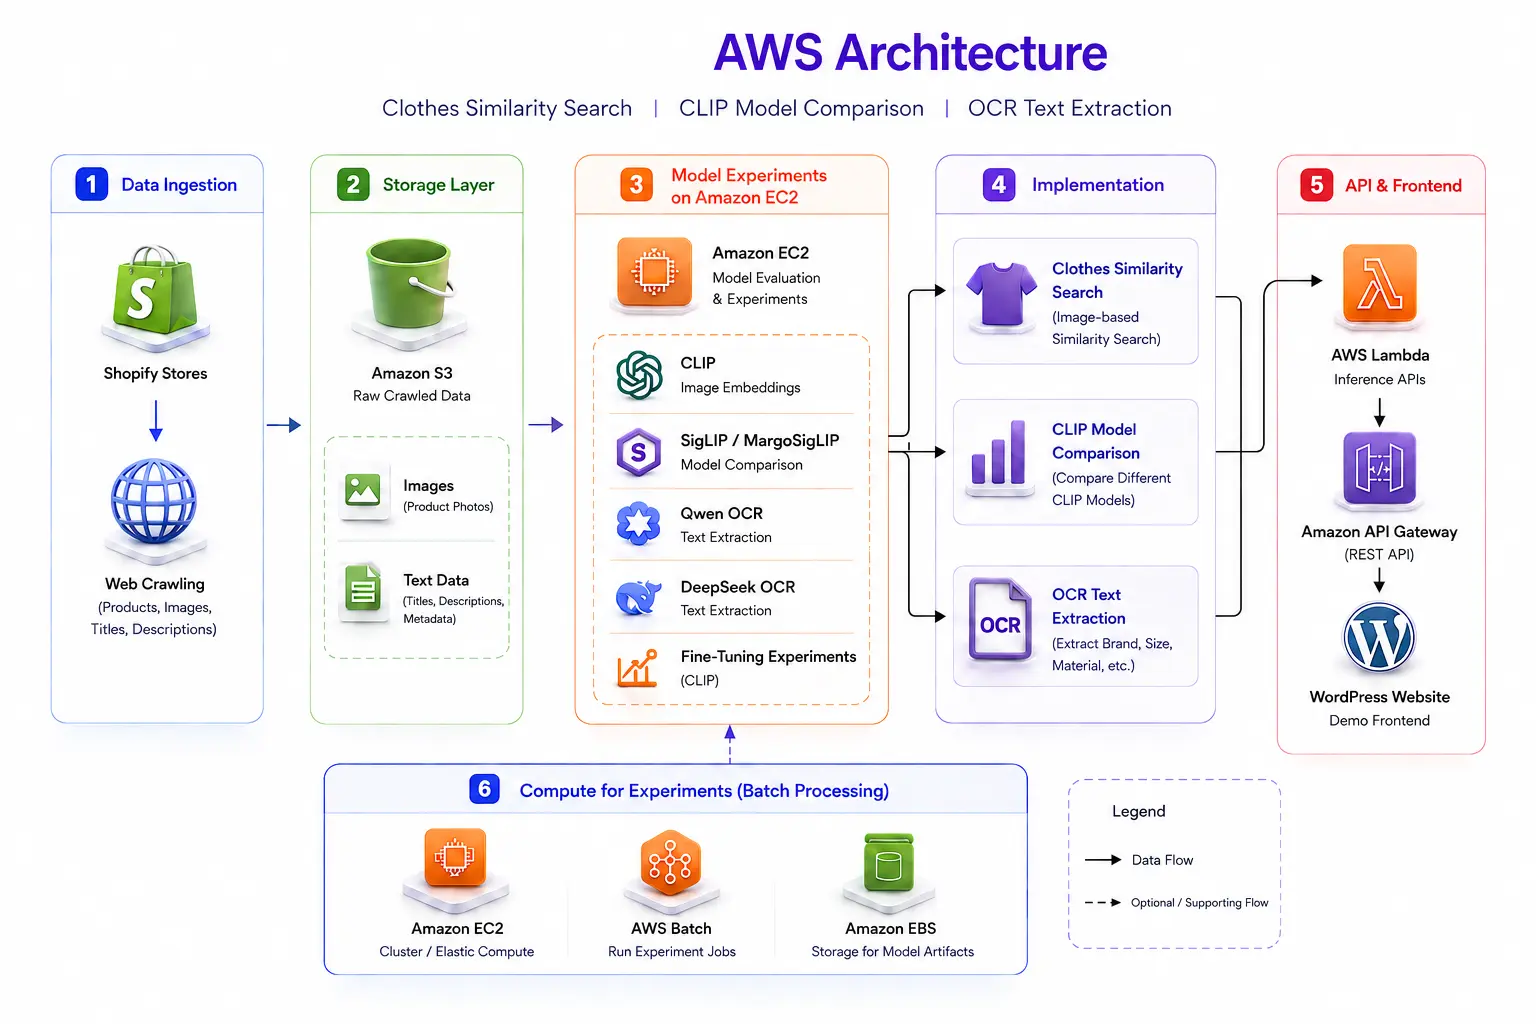
01
Images de produits
Images de produits provenant de plusieurs ensembles de données et magasins.
02
Génération d’embeddings
Des modèles basés sur CLIP génèrent des représentations sémantiques.
03
Similarité et évaluation
Flux de travail pour la recherche, la comparaison, l’évaluation comparative et l’analyse.
04
Environnement expérimental
L’infrastructure infonuagique prend en charge les tests, l’entraînement et les démonstrations.
DÉVELOPPEMENT
Des questions de recherche aux résultats mesurables.
Conception des expériences
La récupération de données, l’extraction OCR, l’évaluation comparative et l’analyse au niveau des magasins ont été structurées autour de questions pratiques d’affaires et techniques.
Ingénierie
Des pipelines de plongements, des systèmes de recherche par similarité, des flux de travail OCR, des cadres d’évaluation et des expériences de réglage fin ont constitué la fondation technique.
Expérimentation infonuagique
Les services AWS ont soutenu l’entraînement des modèles, les points de terminaison d’inférence, les flux de travail d’évaluation comparative et les environnements de démonstration.
RÉSULTATS
Ce qui est devenu visible grâce à une expérimentation systématique.
- Construit des démonstrations fonctionnelles de recherche de produits par similarité
- Évalué plusieurs modèles de type CLIP sur des ensembles de données de produits
- Évalué des systèmes OCR pour l’extraction d’attributs
- Exploré l’analyse des plongements au niveau des magasins
- Mesuré les effets du décalage de domaine entre différents détaillants
- Testé des flux de travail de réglage fin de CLIP à petite échelle
- Identifié les limites des systèmes d’intelligence produit fondés uniquement sur l’analyse visuelle
Principales conclusions
La qualité des données est plus importante que le choix du modèle.
Le nettoyage, la normalisation et la cohérence des données ont souvent produit des améliorations plus importantes que le changement d’architecture.
L’OCR complète les modèles de vision.
Les informations structurées sur les produits sont souvent plus fiables lorsqu’elles sont extraites directement des étiquettes plutôt que déduites visuellement.
La recherche par récupération est plus robuste que la classification.
La recherche de similarité basée sur les plongements vectoriels a démontré une meilleure résilience face au décalage de domaine que les tâches de classification traditionnelles.
Les données du commerce de détail sont très variables.
Les différences entre les magasins influencent considérablement le comportement des modèles, leur capacité de généralisation et les résultats des évaluations.
TECHNOLOGIES / SERVICES
Couche vision-langage
Pour la compréhension des images, la génération de plongements, la recherche par similarité et l’évaluation multimodale.
Couche OCR
Pour l’extraction d’attributs structurés des produits directement à partir des étiquettes et des identifiants des vêtements.
Couche de recherche
Pour l’évaluation comparative des modèles, la mesure du décalage de domaine et l’analyse des résultats expérimentaux.
Infrastructure infonuagique
Pour l’entraînement, l’expérimentation, le déploiement, le traitement par lots et les environnements de démonstration.
Contexte du financement: Soutenu par Investissement Québec et Scale AI dans le cadre d’une initiative de recherche appliquée et d’expérimentation visant à évaluer les capacités de l’IA multimodale au sein d’ensembles de données et d’environnements de commerce de détail.
Projets connexes
Poursuivez votre exploration de nos projets.
Commencez par le résultat d’affaires.
Apportez la question à laquelle vous cherchez à répondre. Nous vous aiderons à déterminer ce qui mérite d’être développé.