LEXA: Cadre d’évaluation de la précision des LLM
Fiers d’être soutenus par Investissement Québec et Confiance IA. Une initiative d’évaluation de l’IA visant à mesurer la fiabilité, l’exactitude et la performance des grands modèles de langage (LLM) pour des applications commerciales.
CADRE D’ÉVALUATION / IA APPLIQUÉE
ÉVALUATION DES LLM / DOMAINE DU COMMERCE ÉLECTRONIQUE
Étude de cas / 07
Contexte du projet
IA appliquée et commerce électronique
Contribution de Plumfind
Évaluation des modèles d’IA
Métriques et outils
Analytique et données
Technologies
LLM, RAG, OCR, méthodes et métriques d’évaluation
ÉTAT DU PROJET
Recherche active / évaluation en cours
DÉFI D’AFFAIRES
L’IA générative doit gagner votre confiance avant d’être déployée.
Les organisations qui adoptent des systèmes de recommandation et d’automatisation propulsés par des LLM ont besoin d’une méthode fiable pour mesurer l’exactitude factuelle, détecter les hallucinations et évaluer la performance dans des environnements réels.
ÉCART ENTRE LA FIABILITÉ DES LLM ET LEUR DÉPLOIEMENT
DÉCOUVERTE ET RECHERCHE
01 / Panorama de l’évaluation
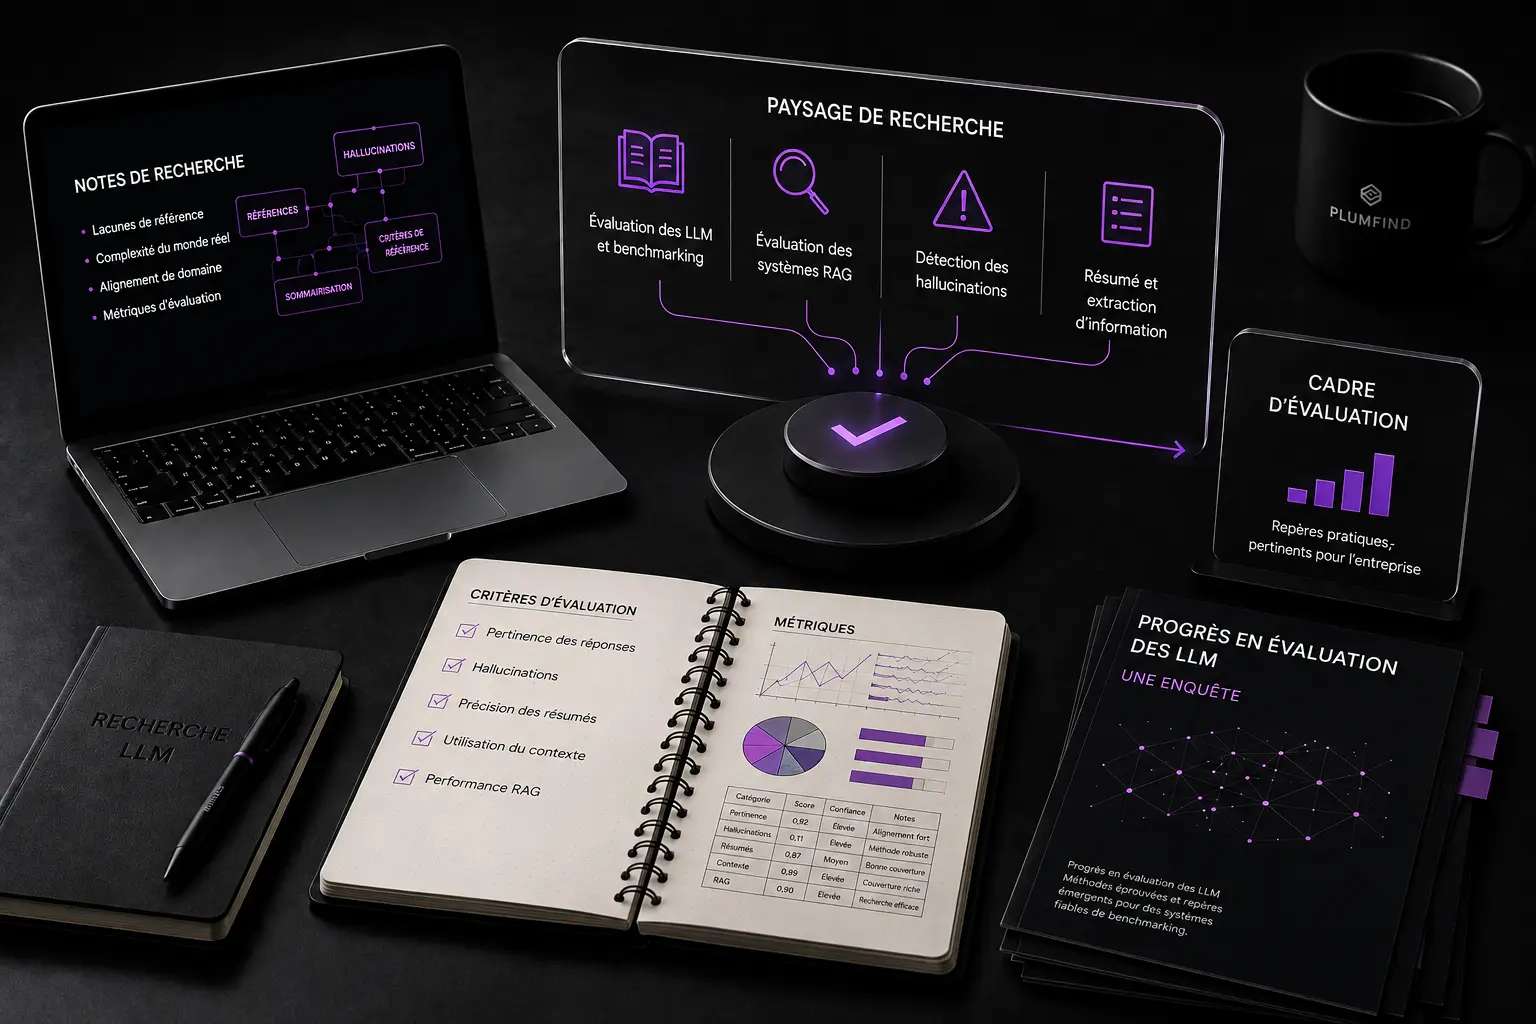
Nous avons analysé les méthodes d’évaluation des LLM, d’évaluation du RAG, de détection des hallucinations et d’extraction de l’information afin de définir un cadre d’évaluation pratique.
02 / Jeu de données propre au domaine
Un jeu de données de catalogue de vêtements basé sur Shopify a permis d’ancrer l’évaluation dans un contexte réel de commerce électronique, avec des descriptions de produits et des métadonnées structurées.
03 / Évaluation de référence
Nous avons testé plusieurs mesures de précision pour l’extraction des caractéristiques, la synthèse, la détection des hallucinations et l’exhaustivité.
04 / Enrichissement multimodal
L’OCR a permis d’extraire des informations sur les produits à partir des images et de les combiner aux métadonnées du catalogue afin de vérifier si l’ajout de contexte multimodal améliore la précision des modèles.
EXIGENCES DE LA RECHERCHE / ÉTUDE DE TERRAIN OPÉRATIONNELLE
Un cadre pratique pour les LLM en contexte réel.
LEXA relie les critères d’évaluation à des données propres au domaine, ce qui permet aux équipes d’évaluer conjointement la pertinence des réponses, les hallucinations, l’exactitude des résumés, l’utilisation du contexte et la performance du RAG.
SOLUTION
Des critères d’évaluation à un cadre fiable.
01
Dimensions d’évaluation
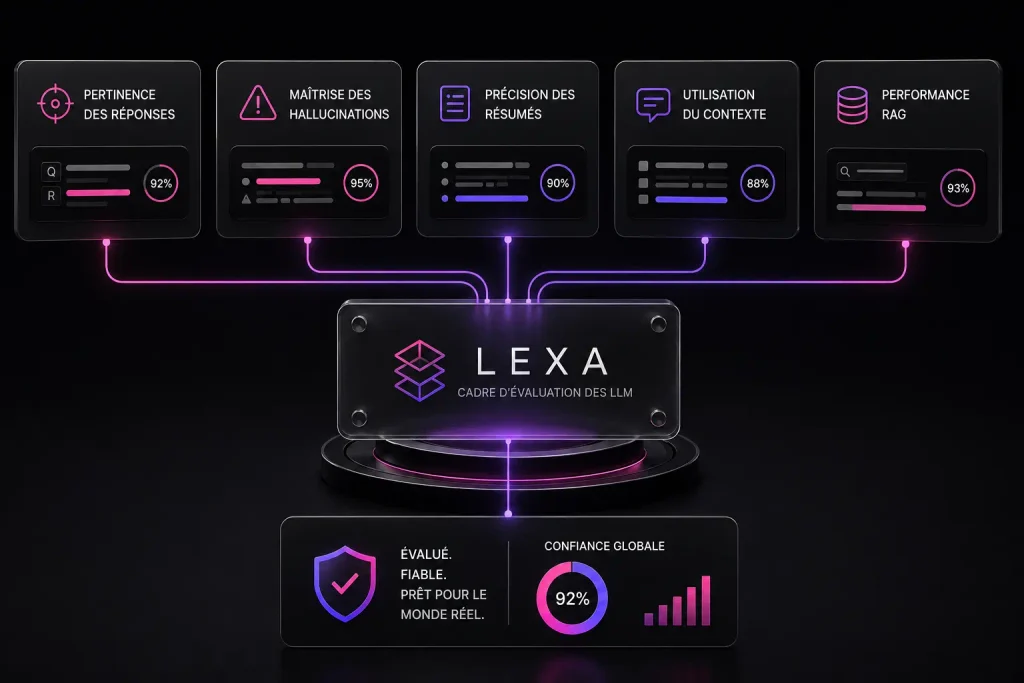
Un modèle clair pour évaluer la pertinence des réponses, les hallucinations, l’exactitude des résumés, l’utilisation du contexte et la performance du RAG a rendu l’évaluation concrète et exploitable.
02
Jeu de données ancré dans le domaine
Un jeu de données du secteur du commerce de détail, basé sur des fiches de produits Shopify accessibles au public, a permis de refléter la complexité réelle du contexte commercial plutôt que de s’appuyer sur un jeu de données universitaire générique.
03
Enrichissement multimodal
L’OCR et l’enrichissement des informations sur les produits ont permis de vérifier si l’ajout de contexte pouvait améliorer la fiabilité des modèles et la qualité des réponses.
Architecture / flux du système
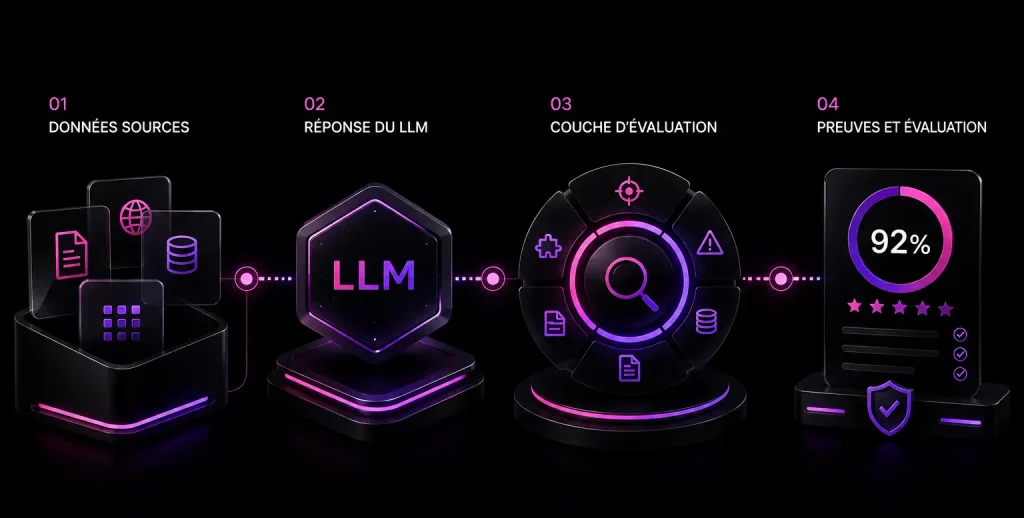
Le système est conçu pour des décisions fiables.
Chaque étape relie les données sources, les réponses des LLM, les critères d’évaluation et les éléments probants afin que les équipes puissent comprendre où la performance est solide et où des améliorations sont nécessaires.
Mise en œuvre
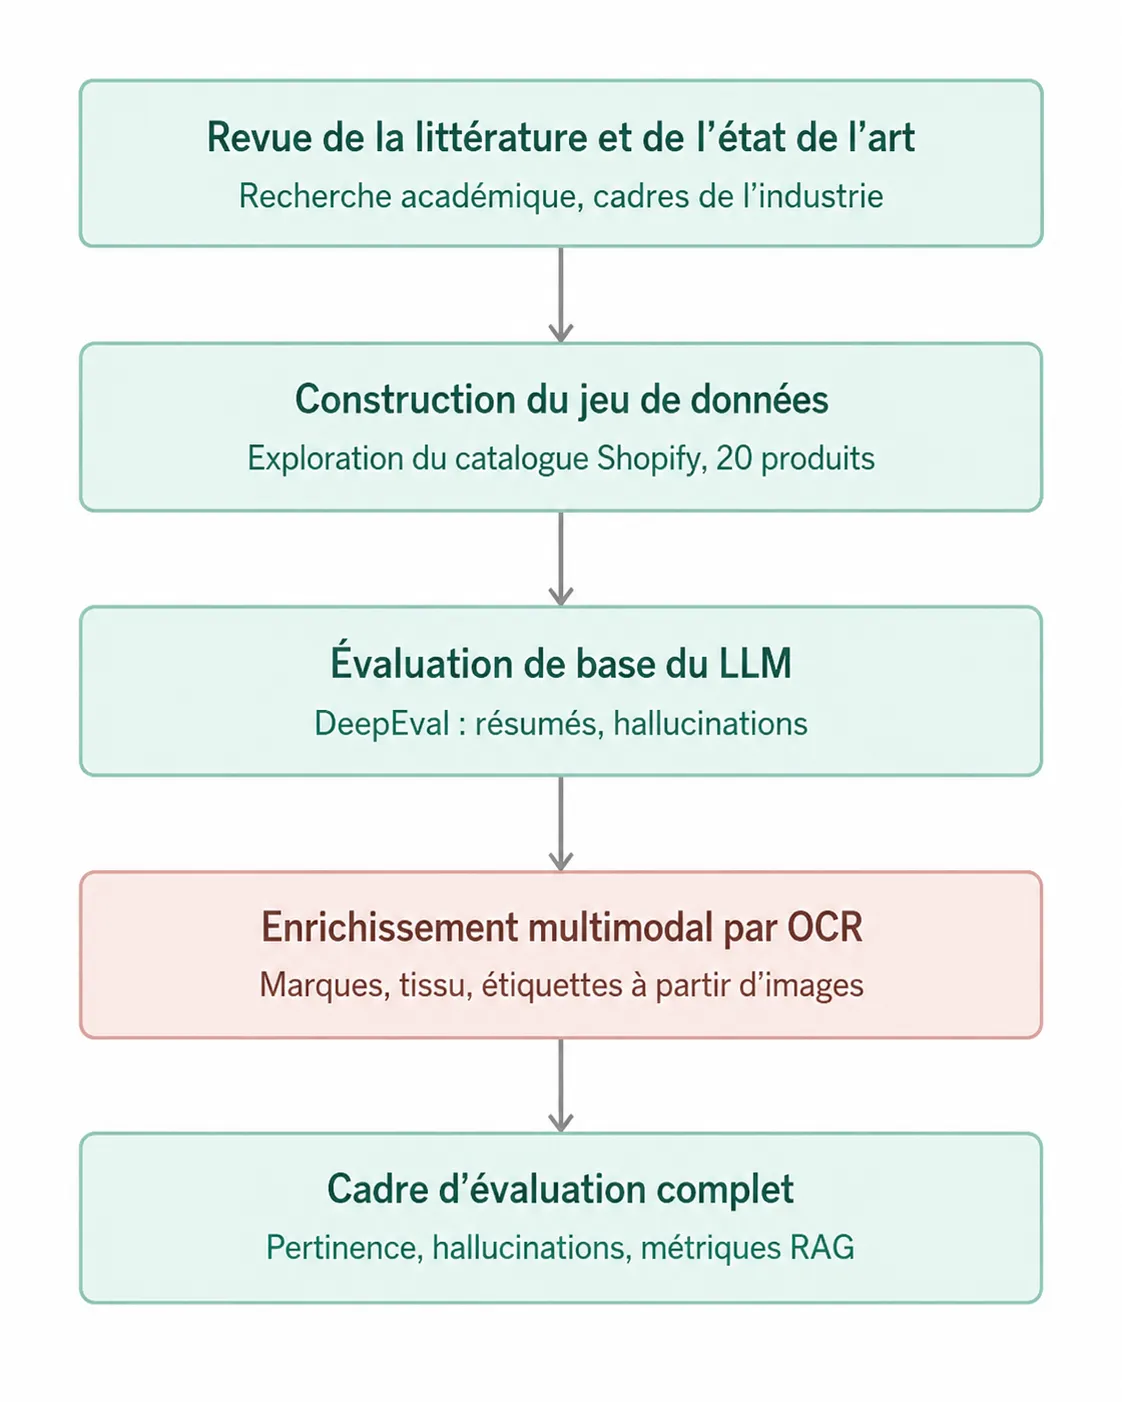
De l’évaluation des modèles à un système d’évaluation fiable.
01
Conception de la recherche et des bancs d’essai
Une revue structurée et un plan d’évaluation ont transformé des méthodes académiques en un cadre de test pertinent sur le plan commercial.
02
Évaluation des LLM et des systèmes RAG
Les modèles de référence, le comportement des systèmes RAG et l’enrichissement multimodal ont été évalués à l’aide d’un ensemble de données spécifique au domaine et de mesures pratiques de qualité.
03
Perspectives et prochaines étapes
Les résultats permettent d’identifier où des données supplémentaires, un meilleur contexte ou un perfectionnement des modèles peuvent améliorer un déploiement fiable.
IMPACT COMMERCIAL
Une IA fiable sur laquelle les équipes peuvent s’appuyer.
- Défini des mesures pratiques pour la pertinence, les hallucinations et la qualité de la synthèse
- Créé un ensemble de données d’évaluation comparative spécifique au domaine du commerce électronique
- Évalué la performance de référence des LLM et des systèmes RAG à l’aide de questions réelles
- Évalué l’enrichissement par OCR et l’efficacité de l’utilisation du contexte
LEÇON APPRISE
Une IA digne de confiance nécessite des méthodes d’évaluation qui tiennent compte de ses données, de ses cas d’utilisation et de ses risques — et pas seulement des tests de référence génériques.
TECHNOLOGIES UTILISÉES
Cadre d’évaluation
IA
Pour mesurer la qualité des modèles en fonction de la pertinence des réponses, des hallucinations, de la synthèse, de l’utilisation du contexte et de la performance RAG.
Ensemble de données de domaine
ANALYTIQUE
Pour ancrer l’évaluation des modèles dans des données réelles sur les produits, des descriptions structurées et un contexte commercial.
Enrichissement multimodal
INFONUAGIQUE
Pour tester si l’OCR et des sources d’information supplémentaires améliorent la qualité et la fiabilité des réponses des modèles.
Projets connexes
Poursuivez votre exploration de nos projets.
ENTAMEZ UNE CONVERSATION
Commencez par le résultat d’affaires.
Apportez la question à laquelle vous cherchez à répondre. Nous vous aiderons à déterminer ce qui mérite d’être développé.